L’essentiel
- Pangram classe plusieurs extraits comme artificiels, sans documenter les conditions réelles de rédaction.
- Les tests disponibles le placent parmi les meilleurs détecteurs, sans garantir chaque résultat.
- Son score doit déclencher une vérification contradictoire, jamais une sanction automatique.
Une accusation lancée le jour du Prix du Roman Fnac
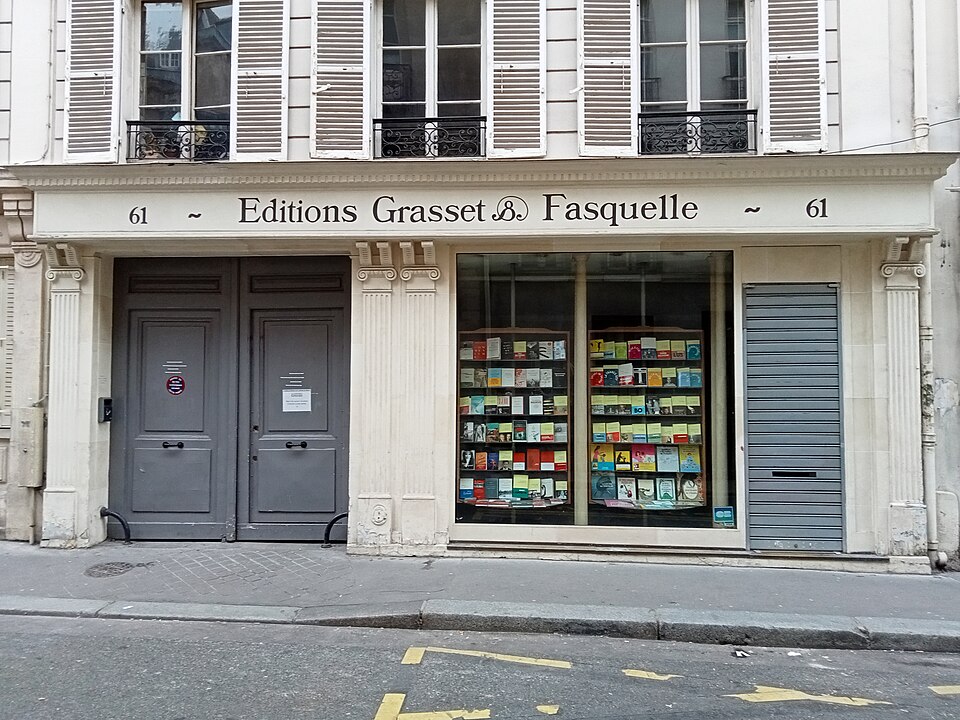
La polémique s’est déclenchée le 21 septembre 2026. Le même jour, Thélyson Orélien recevait le Prix du Roman Fnac pour C’était ça ou mourir, publié le 19 août chez Grasset.
Un compte X nommé « Balance ton Claude » a affirmé avoir soumis plusieurs extraits du livre à Pangram. Selon les captures publiées, l’outil aurait attribué à différents passages une probabilité comprise entre 95 % et 100 % d’avoir été produits par une intelligence artificielle.
France Inter a ensuite rapporté des résultats similaires sur plusieurs passages. Ces analyses ont nourri l’accusation selon laquelle l’œuvre aurait été presque entièrement générée par IA. À ce stade, cette affirmation n’est pas établie. Le logiciel a classé des textes ; il n’a pas reconstitué leur production.
Thélyson Orélien dément tout recours à une machine. Il explique que son écriture s’appuie sur des traditions haïtiennes et caribéennes, avec des répétitions, des images et un rythme oral particuliers. Grasset rejette également les accusations et affirme que l’auteur a toujours écrit. Le désaccord porte donc autant sur l’origine du texte que sur la capacité d’un algorithme à interpréter une langue littéraire atypique.
À lire aussi
- ActualitésEnsol sécurise 2 millions d’euros de projets solaires en un mois et accélère son déploiement en France
- ActualitésImpulsion IA 2027 : ce que le plan de 80 millions d’euros change pour les entreprises
- ActualitésAMD dépasse les 1 000 milliards de dollars : jusqu’où peut aller le rival de Nvidia ?
Comment fonctionne le détecteur d’IA Pangram ?
Le détecteur d’IA Pangram n’accède ni à l’historique de l’auteur ni aux fichiers qui ont servi à rédiger le livre. Il examine le texte fourni et cherche des caractéristiques statistiques associées aux productions des grands modèles de langage.
La société entraîne son système avec des documents humains et leurs « miroirs synthétiques ». Dans son rapport technique sur Pangram 4, elle annonce 0,0041 % de faux positifs et 0,3396 % de textes artificiels non détectés. Ces chiffres sont déclaratifs : plusieurs auteurs du rapport travaillent pour Pangram.
Une étude menée à Chicago Booth a comparé Pangram, GPTZero, Originality.ai et un modèle ouvert sur environ 2 000 passages humains. Pangram y obtient les meilleurs résultats. Toutefois, les chercheurs précisent que les performances varient avec la longueur du texte, le modèle génératif et le seuil choisi. Elles diminuent notamment sur les passages très courts.
Un score élevé ne révèle pas le processus d’écriture
Le problème central vient de l’interprétation du résultat. Une probabilité de 100 % affichée par un logiciel ne signifie pas que la réalité est connue avec une certitude absolue. Elle indique que le texte ressemble fortement, selon ce modèle et ses données d’entraînement, aux contenus classés comme artificiels.
Plusieurs situations brouillent cette frontière. Un auteur peut utiliser un correcteur, traduire une phrase avec une IA ou faire reformuler un paragraphe. À l’inverse, un texte généré peut être profondément réécrit. En littérature, une prose répétitive ou très structurée peut aussi présenter des régularités associées à une machine.
Des chercheurs de Stanford avaient déjà montré que plusieurs détecteurs pénalisaient davantage les personnes écrivant en anglais comme langue seconde. Cette étude de 2023 ne portait pas spécifiquement sur la dernière version de Pangram. Elle démontre néanmoins que la performance générale d’une famille d’outils ne suffit pas à exclure les biais liés au style ou au contexte.
Pourquoi plusieurs scores ne forment pas plusieurs preuves
Les auteurs de l’accusation ont mis en avant la répétition des scores élevés sur différents extraits. L’argument paraît puissant : si le taux de faux positifs est très faible, vingt résultats convergents sembleraient presque impossibles à obtenir par hasard.
Ce raisonnement suppose que les tests sont indépendants. Or les passages d’un même livre partagent un style et un vocabulaire. Si le logiciel interprète mal une caractéristique présente dans tout le roman, l’erreur peut se répéter. Tester uniquement des extraits jugés suspects crée aussi un biais. Un protocole robuste devrait fixer à l’avance leur choix, leur longueur et les textes de comparaison.
Les éditeurs ont besoin de preuves de processus
L’affaire place les éditeurs face à un problème de gouvernance. Ils doivent protéger la confiance des lecteurs, les droits des auteurs et la réputation de leur catalogue. Cependant, une sanction prise sur le seul fondement d’un détecteur pourrait exposer un auteur à un préjudice considérable.
La meilleure preuve ne se trouve pas forcément dans le texte final. Elle réside souvent dans le processus : versions successives, fichiers horodatés, notes préparatoires, carnets, échanges avec l’éditeur et historique des corrections.
Une affaire comparable l’a montré en 2026. Une nouvelle primée par le Commonwealth avait été signalée comme artificielle. Son auteur a finalement convaincu l’organisation en présentant ses brouillons, son plan et les traces de son travail.
Les maisons d’édition devraient donc définir une politique claire avant qu’une crise survienne. Le contrat peut préciser les usages autorisés : correction, traduction, recherche, aide à la structure ou génération de passages. L’auteur doit aussi savoir ce qu’il doit déclarer et quels éléments il doit conserver.
Cette question rejoint plus largement le débat sur l’intelligence artificielle et le droit d’auteur. L’origine des textes, la traçabilité des données et la responsabilité contractuelle deviennent des éléments économiques de la chaîne éditoriale.
Un risque qui dépasse largement le secteur du livre
Les recruteurs, universités, médias et entreprises utilisent aussi des détecteurs pour contrôler des candidatures, des devoirs, des articles ou des rapports. Pourtant, les conséquences d’un faux positif peuvent être disproportionnées : exclusion, rupture de contrat, accusation de fraude ou atteinte durable à la réputation.
Un détecteur peut servir de signal d’alerte. Il peut justifier un contrôle supplémentaire ou une demande d’explication. En revanche, il ne devrait pas décider seul. Toute décision sensible exige une revue humaine, des éléments contradictoires et une possibilité de contestation.
Cette prudence correspond aux règles de gouvernance déjà nécessaires lorsqu’une entreprise déploie de l’IA. Business Times a notamment rappelé l’importance de documenter les traitements et de maintenir une validation humaine.
Dans les médias, la pression sera tout aussi forte. La valeur d’un titre dépend de la confiance accordée à ses contenus et à ceux qui les produisent. L’évolution du secteur, déjà fragilisé par les transformations technologiques, avait été analysée par Business Times lors de la reprise du Journal des Entreprises sans ses journalistes permanents.
Ce qu’il faut surveiller
La polémique ne démontre pas que Pangram est inutile. Les tests disponibles montrent au contraire qu’il surpasse de nombreux concurrents. Elle révèle plutôt le risque créé lorsqu’un score sort de son cadre statistique et devient un verdict public.
Il faudra d’abord surveiller la publication éventuelle d’éléments matériels : brouillons, versions horodatées ou historique des corrections. Ils pourraient documenter le processus d’écriture sans dépendre d’un second détecteur. Une évaluation indépendante du roman, fondée sur un protocole publié, apporterait aussi davantage qu’une succession de tests effectués sur des extraits choisis.
Pour Grasset, l’enjeu consiste à défendre son auteur tout en documentant le processus éditorial. Pour Pangram, cette exposition constitue à la fois une vitrine commerciale et un test de crédibilité. Une entreprise qui promet une détection presque parfaite doit expliquer les limites de chaque résultat.
Enfin, pour les dirigeants, la règle devrait être simple : plus une décision peut nuire à une personne, plus la preuve exigée doit dépasser le résultat d’un algorithme. L’IA peut aider à repérer une anomalie. Elle ne dispense ni de l’enquête, ni du contradictoire, ni de la responsabilité humaine.
À lire également sur Business Times
- ActualitésData center Google à Châteauroux : 195 hectares, emplois, électricité… ce que le projet implique vraiment
- TechnologiesL’IA change de dimension : chez Inetum, le défi est désormais de créer la confiance
- ActualitésCybersécurité des entreprises : le rôle clé des dirigeants
- ActualitésIA autonome : Yoshua Bengio alerte sur une possible perte de contrôle